AI 辅助编程
什么是 Vibe Coding
Vibe Coding(氛围编程) 是一种 AI 辅助的软件开发实践:开发者用自然语言向大语言模型(LLM)描述需求,由 AI 生成代码,开发者通过运行结果而非阅读代码来判断是否正确。
和传统 AI 辅助编程的关键区别在于——开发者主动放弃对代码的逐行理解。
正如 Simon Willison 所说:
“如果 LLM 写了你所有的代码,但你逐行审查、测试、理解了它,那不叫 Vibe Coding——那叫用 LLM 当打字助手。”
显然,vibe coding 看上去并不是一个 靠谱 的编程方法,但是很多时候我们出于以下可能的原因,其实需要,或者不得不使用 vibe coding。
- 想要独自快速开发一个小项目,但是你对这个项目所需的编程语言和工具(统称为技术栈)一窍不通。
- 想要复现一个论文/本地部署一个开源项目,但是在尝试的过程中出现问题,且在互联网上没有搜到对应报错的解决方案,也没有大佬可以请教。
- 课程大作业 ddl 前需要交付一个能跑的东西,而不是一个优雅的艺术品。
这些任务如果不靠 AI 生成代码,光是补齐前置知识就足以让人放弃。
但纯粹的 vibe coding 远没有用尽 AI 的能力上限。能不能把事情做成,取决于两个因素:AI 的能力,和你使用 AI 的水平。两者加起来够用,任务就能完成——这也意味着,任何一边不够,都可以靠另一边补上来一部分。所以本章会讲两件事:怎么拿到能力足够强的模型,以及怎么把自己的使用水平提上去。
在开始下面的说教之前,大家可以根据自己的理解,思考一下纯 vibe coding 在做哪些任务的时候不太擅长,有什么解决方案吗?
模型、网页版 AI 与 Harness
大家最熟悉的 AI 形态是网页版对话框:你提问,它把代码以文本形式发给你。这是最原始也最普及的 vibe coding 方式。
但你在网页上看到的那个“AI”,并不等于模型本身。你输入的每句话都不会直接送到模型,中间还隔着一层壳:它替你拼上系统提示词、把历史对话整理好,决定让模型看到什么、允许模型做什么。这层壳叫 harness。
于是同一个模型,套上不同的 harness,你实际拿到手的能力可以天差地别。而网页版是其中最弱的一种:它读不到你的项目,也跑不了你的代码。你想让它改一个文件,只能自己复制进去、再把结果粘回来——你在亲自充当模型的手和眼睛。
真正好用的 harness 长在你自己的电脑上,能直接读写项目文件、执行命令、看到报错输出。这类工具有不少,长相也各不相同,下一节我们就挑一个装上。
记住这个区分,以后就不会把“AI 变笨了”“AI 不听话”一概归咎于模型——很多时候问题出在这层壳上,或者出在你没给够上下文。
本地 Harness 入门
AI 辅助编程一定要有 AI 📕🖊
现在从网页版毕业,换成一个能读你的项目、能跑你的代码、能自己改文件的 harness。这类工具的长相差别很大,但内核是同一件事,挑一个顺手的就行:
| 形态 | 例子 | 特点 |
|---|---|---|
| 命令行(CLI) | Claude Code、Codex CLI、Gemini CLI | 最轻,一条命令装完;新功能通常先在这里出现;代价是要习惯在终端里干活 |
| 桌面客户端(GUI) | 上面这些工具的官方桌面版 | 同一个内核套上图形界面,能直接点开文件看改动 |
| 编辑器内置 | Cursor、VS Code 插件 | 和你写代码的地方在一起,方便你自己去写代码 |
选哪种形态并不重要——它们的用法和背后的道理完全一样。 本节以 CLI 为主线,一是因为它最能让你看清 harness 到底在替你做什么,二是它最不容易过时——图形界面每个版本都在挪位置,而命令行里那几条命令这几年一直是这样。等你之后换成 GUI 或者编辑器,这里学到的东西可以直接搬过去。
我将用目前最先进的 harness —— Claude Code 为示范,接入的模型是 7 月底推出的 deepseek-v4-flash 正式版,下面假设你在 Windows 环境下。
安装 harness
从终端与命令行章节,我们学会了打开命令行。在任意目录下打开 PowerShell:
irm https://claude.ai/install.ps1 | iex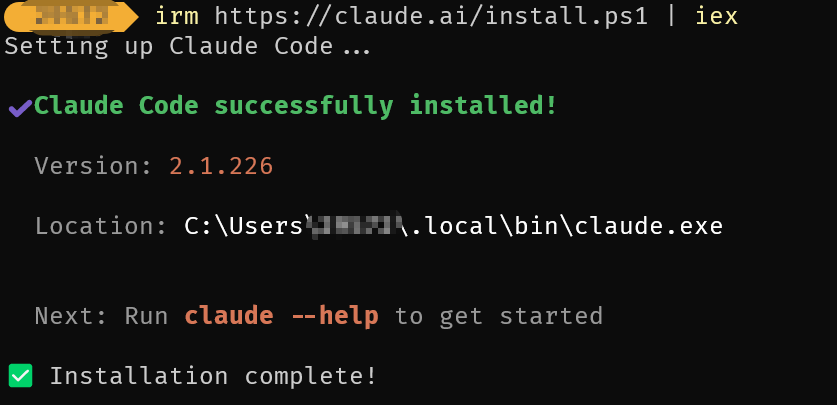
获取 API
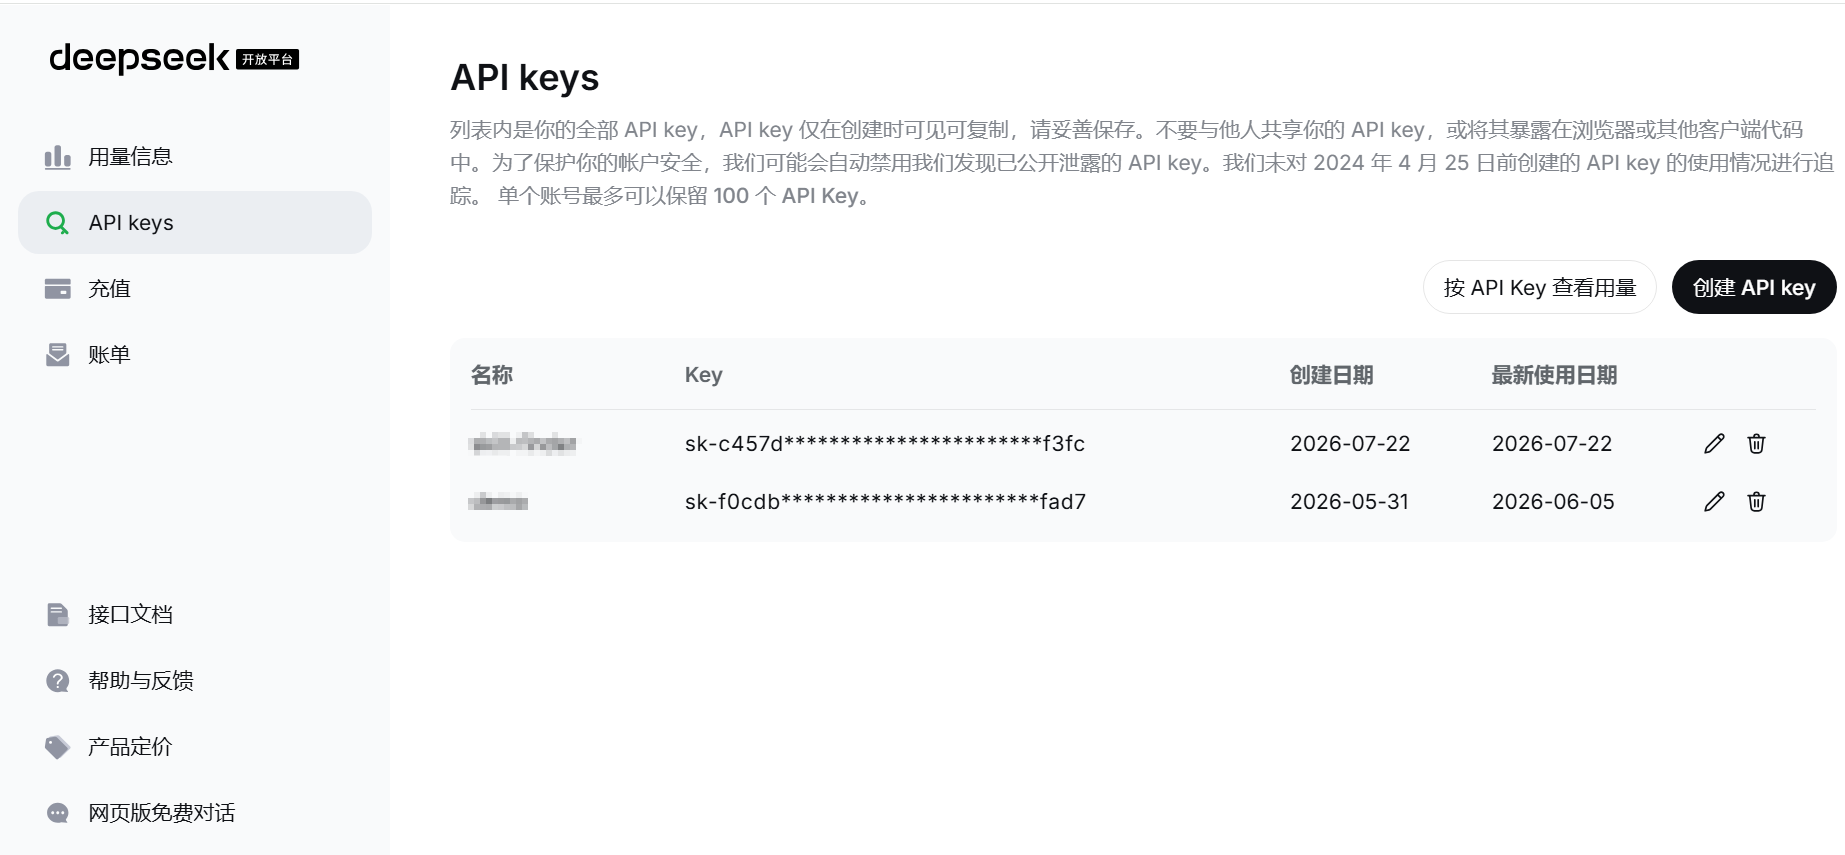
访问 DeepSeek 开放平台,按照提示进行充值,不要充太多,10 块钱就可以用好久,然后点击 API keys,生成一个 Key。
配置 API
实际上 Claude Code 是给 Anthropic 公司自己的模型 Claude 使用的 harness,但是出于某些原因不想用这个模型,所以我们将把 DeepSeek 模型接入 Claude Code。
打开 C:\Users\你的用户名\.claude,你也可以直接点进 C 盘,选择 用户(或 Users),然后在里面选。
如果你在自己的用户目录(也就是 C:\Users\你的用户名,习惯上叫家目录)里没有找到 .claude 这个文件夹,最省事的办法是在 PowerShell 里让它自己建:
mkdir ~/.claude
cd ~/.claude之所以不建议在资源管理器里手动新建,是因为它对以点开头的名字支持得很不一致,你可能会得到一个"必须键入文件名"的报错。建好之后在里面新建 settings.json。
打开 settings.json,将下方的语句复制粘贴进去:
{
  "env": {
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "128000",
    "CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS": "1",
    "ANTHROPIC_API_KEY": "你刚刚生成的deepseek api key,sk-开头的那个",
    "ANTHROPIC_BASE_URL": "https://api.deepseek.com/anthropic"
  },
  "model": "deepseek-v4-flash"
}两个 ANTHROPIC_ 变量就是全部的关键:一个说去哪儿要模型,一个证明你是谁。后面那个 /anthropic 结尾的地址是 DeepSeek 专门为 Claude Code 这类工具准备的兼容入口。
再次随便选择一个文件夹打开 powershell,输入
claude即可打开 Claude Code 界面,它如果问你是否要用这个 key,选 yes,然后就能看到这样的页面:
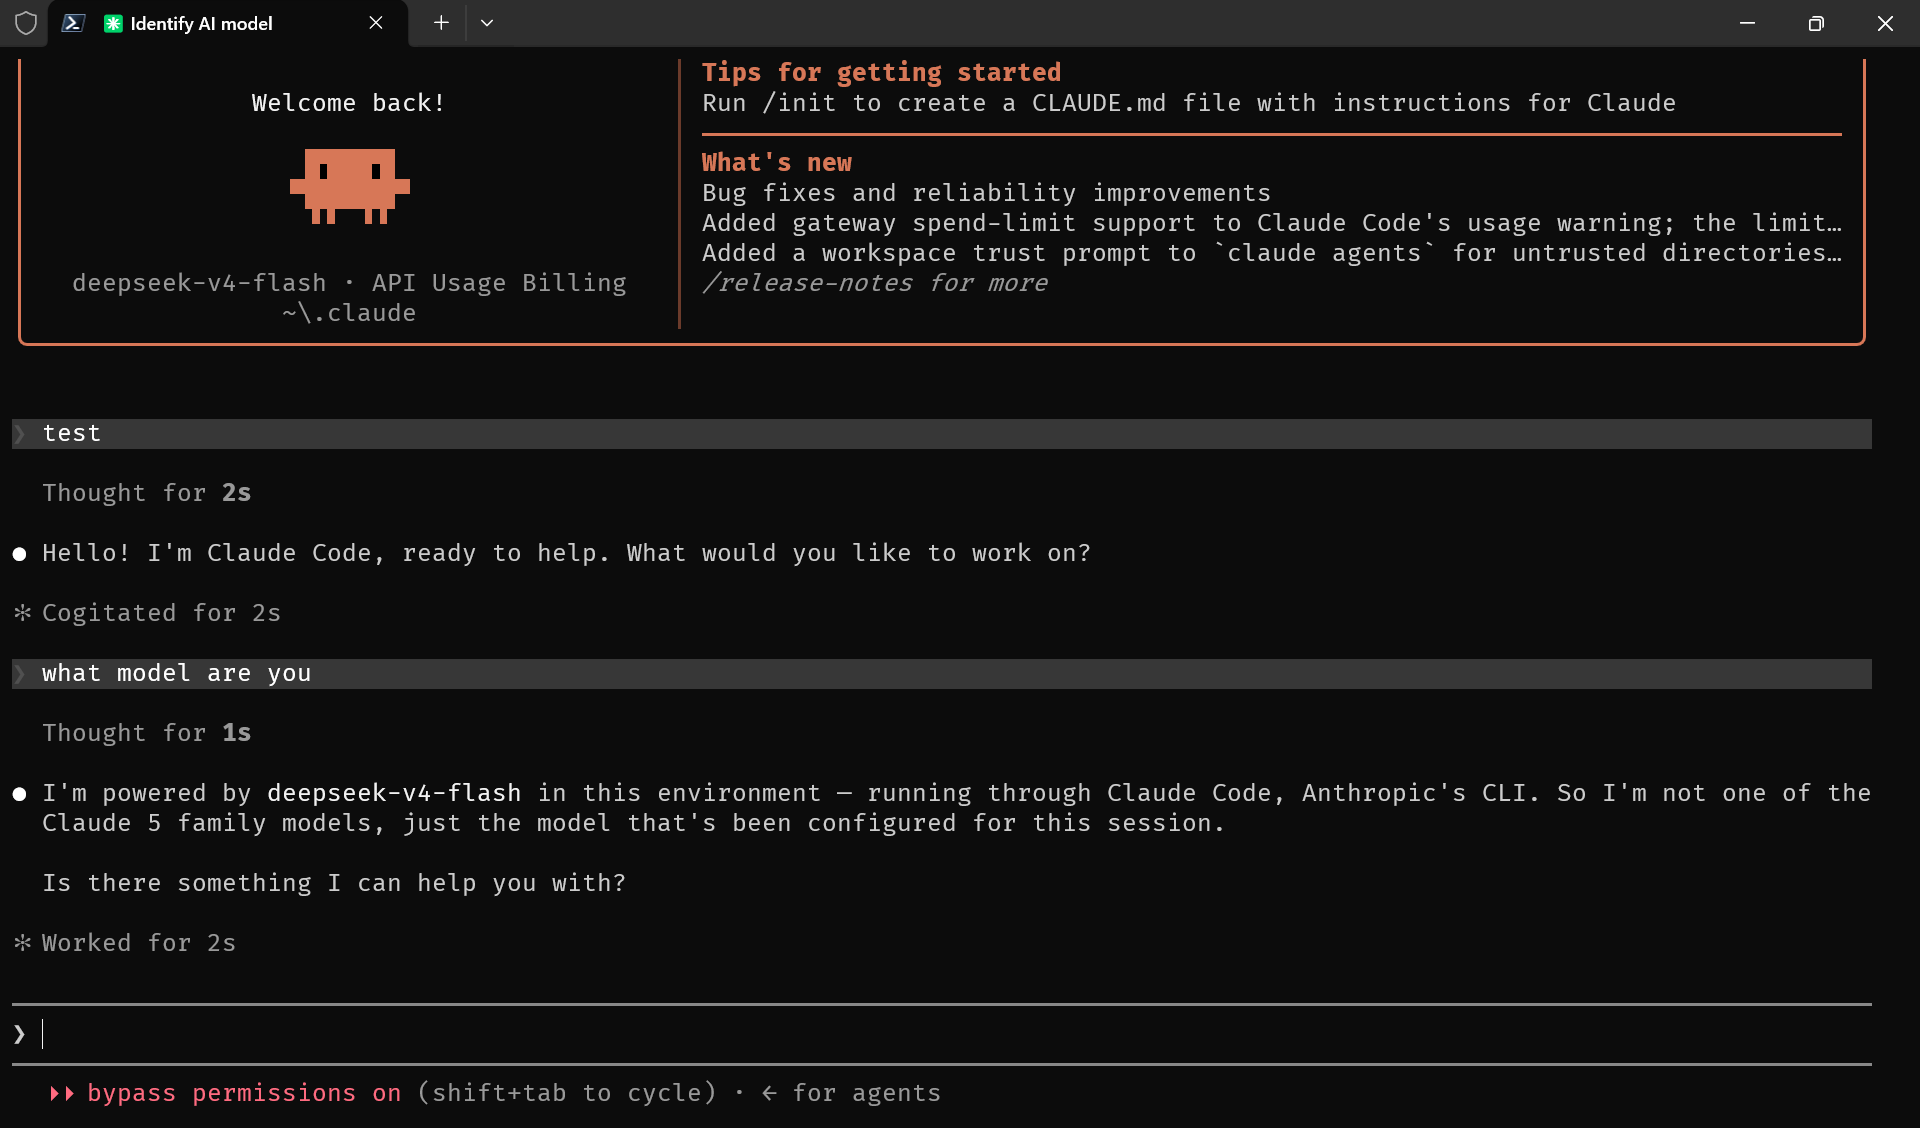
可以在下面提问。
你可能注意到截图左下角有一个 bypass permissions on,那是我自己开的,你现在不会有——也先别去开。等你做完第一个任务,就知道它关掉的是什么了。
尝试你的第一个任务
输入以下文字:
帮我在桌面新建一个文件夹,做一个 2048 小游戏:
1. 做成一个独立的 HTML 文件,双击用浏览器打开就能玩,不需要联网,不需要安装任何东西
2. 4×4 的方格棋盘
3. 用方向键(↑↓←→)控制方块移动,也支持 WASD
4. 相同数字的方块碰到一起会合并成它们的和
5. 合并逻辑和原版 2048 一致:一次滑动里每个方块最多被合并一次
6. 每次有效移动后,在空位置随机出现一个 2 或 4
7. 合并出 2048 就提示"你赢了!"
8. 界面显示当前分数和最高分
9. 数字用不同颜色区分,整体美观一点

写完后告诉我文件叫什么名字、怎么打开来玩。回车之后,它不会直接开始写。它会先停下来问你。 每次它要动你磁盘上的文件、或者要在你的终端里执行一条命令,都会先弹出一个确认,大意是这样(具体措辞随版本变):
Create file
  2048.html

Do you want to create 2048.html?
❯ 1. Yes
  2. Yes, allow all edits during this session
3. No, and tell Claude what to do differently这就是本地 harness 和网页版最大的区别。 网页版只能把代码吐给你,能不能落到你的电脑上,全靠你自己复制粘贴;而它现在是真的要新建文件、真的要跑命令,所以每一次动手之前都得先问过你。第 2 节说的"harness 决定允许模型做什么",具体就体现在这里。
第一次跑的时候,请老老实实一个一个看过去再按 1。你会发现它要做的事比你想象的多:建文件夹、写文件、有时候还要跑一条命令去验证结果。这几分钟是这一章里最值得花的时间——它让你对"AI 到底能碰到我电脑上的什么"有一个具体的概念,而不是一个模糊的印象。
选项 2 是个很实用的中间档:同一件事重复问烦了,就让它在这次会话里别再问了,范围只限这一次会话,关掉终端就失效。
这个任务足够简单,AI 可以快速地完成。
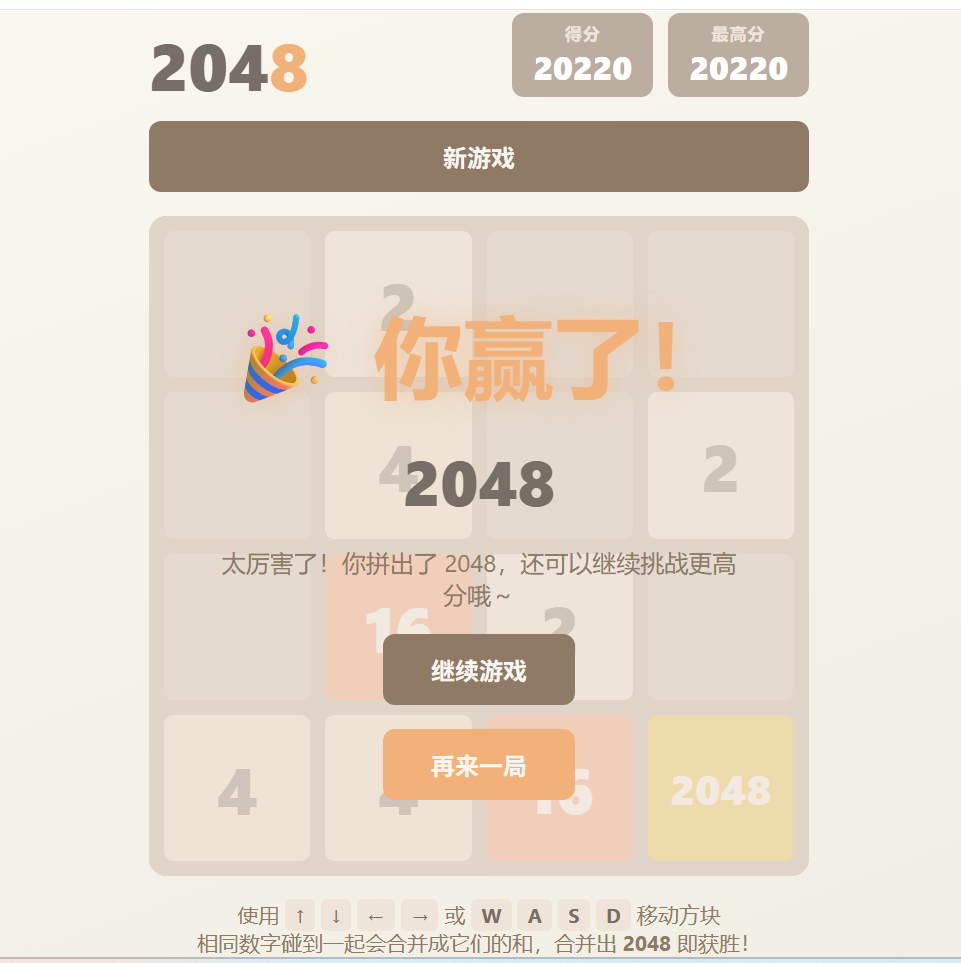
玩过一局之后,你可以继续输入:
帮我再加一个功能:把最高分保存到浏览器本地(localStorage),刷新页面后分数不丢。然后等你又玩了一局之后,可以再加一点更炫酷的功能:
再加一个"撤销上一步"的按钮,点一下能回退上一次移动。

赢出 2048 后不要结束游戏,让我可以继续玩,目标改成 4096。如果你以上都做完了,恭喜,你已经成功地使用本地 harness 做出了你人生中第一件 vibe coding 作品 🎊
现在再说那个 bypass permissions
一路点下来,你已经很清楚它在拦什么了:每一次写文件,每一次执行命令。
如果嫌烦,可以在启动的时候把这道闸门整个关掉——这就是截图里 bypass permissions on 的来源:
claude --dangerously-skip-permissions关掉之后确实爽很多,AI 可以一口气把十几个文件改完,中间完全不打断你。代价是你失去了最后一道人工闸门:它删错了文件、跑了一条你没料到的命令,你都是事后才知道的。这个 flag 的名字里带着 dangerously,是官方特意起的,不是玩笑。
所以给一条具体的界限:
- 在一个用 Git 管起来的目录里,可以放开。改坏了
git checkout一下就回来了(参见 Git 与 GitHub:使用 Git)——这也是为什么下一步就该去学 Git。 - 在桌面、下载文件夹,或者任何混着重要文件的地方,不要放开。也就是说,刚才那个 2048 的目录恰恰是不该放开的地方。
- 日常更常用的其实还是选项
2:按需放开一次会话,而不是永久拆掉。
拿到 AI:账号、付费与中转站
上一节你已经有一个能跑的东西了,而且用的是最省事的那条路:国内模型,支付宝充值,十块钱。
但你迟早会撞上它的天花板——任务一复杂就绕圈、改着改着把别的地方弄坏。这时候真正的瓶颈从"会不会用"变成了"用不上":口碑最好的那几个模型,对国内用户恰恰最不友好。这一节讲的就是怎么把它们拿到手,以及每条路各自的代价。
后面几节的内容——怎么把需求说清楚、怎么管上下文——都和你用哪个模型无关。 上一节那个十块钱的 DeepSeek 一样能把后面全部学完,而且便宜到你可以放心地大量试错。所以这一节要是没搞定,或者干脆不想折腾,都不用卡在这里,直接往下看。
现在有哪些能用的模型
| 阵营 | 代表 | 大致情况 |
|---|---|---|
| Anthropic | Claude | 在写代码、听懂指令、长时间自己干活上口碑最好,本地 harness 的生态也最成熟。代价是对国内用户最不友好:官方服务没有开放中国大陆地区 |
| OpenAI | GPT / Codex | 综合能力强,周边生态和第三方工具最多,每个星期有较少的免费额度。体感上它更照字面办事:你说什么它就做什么,不太会替你补全意图,也很少通过反问用户去确认 |
| Gemini | 免费层通常最大方,适合零成本试水;写代码上的口碑不如前两家,本地 harness 生态也相对弱一些 | |
| 国内厂商 | DeepSeek、Qwen、Kimi、GLM 等 | 支付宝微信直接充值,网络无障碍,价格往往低一个量级。最难的任务上和上面几家还有差距,但日常写代码完全够用 |
这里单独把上面提到的“照字面办事”拎出来说,因为它是新手最容易踩的坑:
AI 执行的是你写下的那句话,不是你脑子里的那件事。
你写“帮我把这个函数改快一点”,你脑子里其实还跟着一堆没说出口的前提:不能改函数签名、不能引入新的依赖、结果必须和原来一样。这些你觉得“不是显然的吗”的东西,它并不知道,于是它可能给你一个跑得飞快但答案是错的版本——严格符合你的字面要求,完全不是你想要的东西。
不同模型在“愿不愿意替你猜”这件事上确实有倾向差别,有的会反问,有的直接开干。但没有任何模型能猜到你压根没说的东西,所以真正的解法不是换模型,而是第 6 节要讲的:怎么把需求说清楚。
至于选型本身,不要在这一步焦虑,也不要去背跑分榜。你现在选哪家都不要紧——绝大多数 harness 都能换模型,换的成本通常就是改一个环境变量。先让自己有一个能跑的东西,比选出“最好的”重要得多。
免费额度与学生优惠
这一小节要放在花钱之前。 不少人没意识到自己完全可以先零成本跑起来:模型厂商自己的免费层、教育邮箱能认证的一些服务、以及部分工具对学生和开源项目的减免。
去哪里查:各家官网的 Pricing 或 Developer 页面翻 “Free tier”;工具类产品翻它的 Education / Students 页面;以及所在学校有没有统一采购的服务——这一条最容易被忽略,也往往最实惠。
判断值不值:免费额度通常有两种缩水方式,一是只给较弱的模型,二是只能在官方网页里用、不给 API。前者能用来试水,后者接不进本地 harness,对本章后面的内容帮助有限。
国外服务的注册与付费
三道门槛:网络、身份、支付。
网络参见 爱的魔法,这里只补一句经验:注册和日常使用尽量保持在同一个出口地区,频繁跳区是触发风控的常见原因。
身份一般就是邮箱加手机号验证,问题在于你没有国外手机号,所以如果要求你进行手机号验证,你就只能借用国外朋友的手机号,或者用临时手机号去接码,非常的麻烦。
但是国外有一些信任机制,使得不是所有账号都需要手机号验证,经过研究,以下方案大概率不会有问题:
注册一个 proton 邮箱 ,然后长期挂在日本节点上注册并访问各个国外 AI 网站。
支付是真正卡人的一道。
首先分清你要买的是哪一种东西:
| 包月订阅 | API 按量付费 | |
|---|---|---|
| 买的是什么 | 官方入口的使用额度 | 按 token 调用模型的权利 |
| 能用在哪 | 官网网页、官方客户端和官方 CLI | 任何 harness,包括第三方的 |
| 怎么花钱 | 每月固定,用不完不退,用超了限流 | 用多少算多少 |
| 适合谁 | 每天都用、用量稳定 | 偶尔用,或者想接自己的工具 |
除此之外还有第三种:工具自带的订阅。Cursor、GitHub Copilot 这类产品卖的是它自己的会员,你如果买了它的会员,就可以想用 gpt 就用 gpt,想用 kimi 就用 kimi,它会按照模型的单价去算你的额度(比如一个月不能用超过 20 刀)。
给新手的建议:先按量充一小笔,够你用一两周就行。先确认自己真的会天天用它,再考虑订阅——很多人是买了包月之后才发现自己一个月只用了三次。
至于怎么把钱付出去,大致有三类路子,代价各不相同:
- 自己或很熟的朋友或家人的境外信用卡——最稳的一条,基本不会因为支付方式本身出问题。
- 虚拟信用卡一类的服务——能成,但多了两层风险:卡本身可能被上游风控拒掉,服务商自己也可能跑路。
- 代充、合租、买现成账号——最省事,也最不可控。账号不真正属于你,随时可能失效,而且这类做法通常违反服务条款。
根据我个人的经验,如果想要用官方渠道的国外模型,且身边人没有境外信用卡的话,可以尝试 Cursor。
Cursor 最低档 20$/月,超出额度后可以继续用(On demand,从你绑定的支付方式扣款)。这是身边没有境外信用卡时比较现实的一条路。
网上能买到各种"低价号""速刷号",可以买一个 pro 成品号然后使劲蹬——超出的额度会被记在原卡主上,或者是让 Cursor 吃坏账。
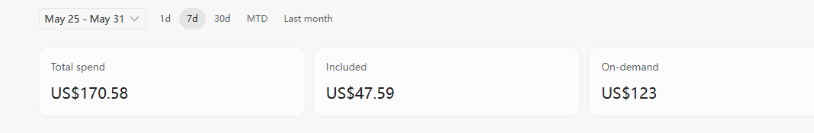
而且虽然这个账号是临时的,但是切到别的号去之后本地的聊天记录和上下文会被保留。
中转站(API 代理)
“中转站” 这个词,在 AI API 圈子里已经存在很久了。
基本上很多人都知道这个名词,但是由于技术门槛、部署成本,或者其他原因,并没有真正自己部署过,所以对其中很多细节并不清楚。
这个词意味着风雨同舟
意味着 any,也意味着各种各样的翻车或者良心。
今天带大家了解一下中转的运行方式、成本、倍率,以及一些常见的风险判断方式。
中转站常见程序
目前中转站一般使用几类程序:
- newapi
- sub2api
- CPA
其中 newapi 是从 oneapi 延伸出来的项目(GitHub - QuantumNous/new-api)。
它的主要作用,是将你的 API 通过中转的方式分发出去。
例如,你有渠道,可以通过美元向 OpenAI 购买 API,然后把它中转给用户使用。用户使用的时候,会受到后台规则约束。你可以给他们设置额度、倍率、可使用模型等。
所以这个程序的主要作用就是分发。
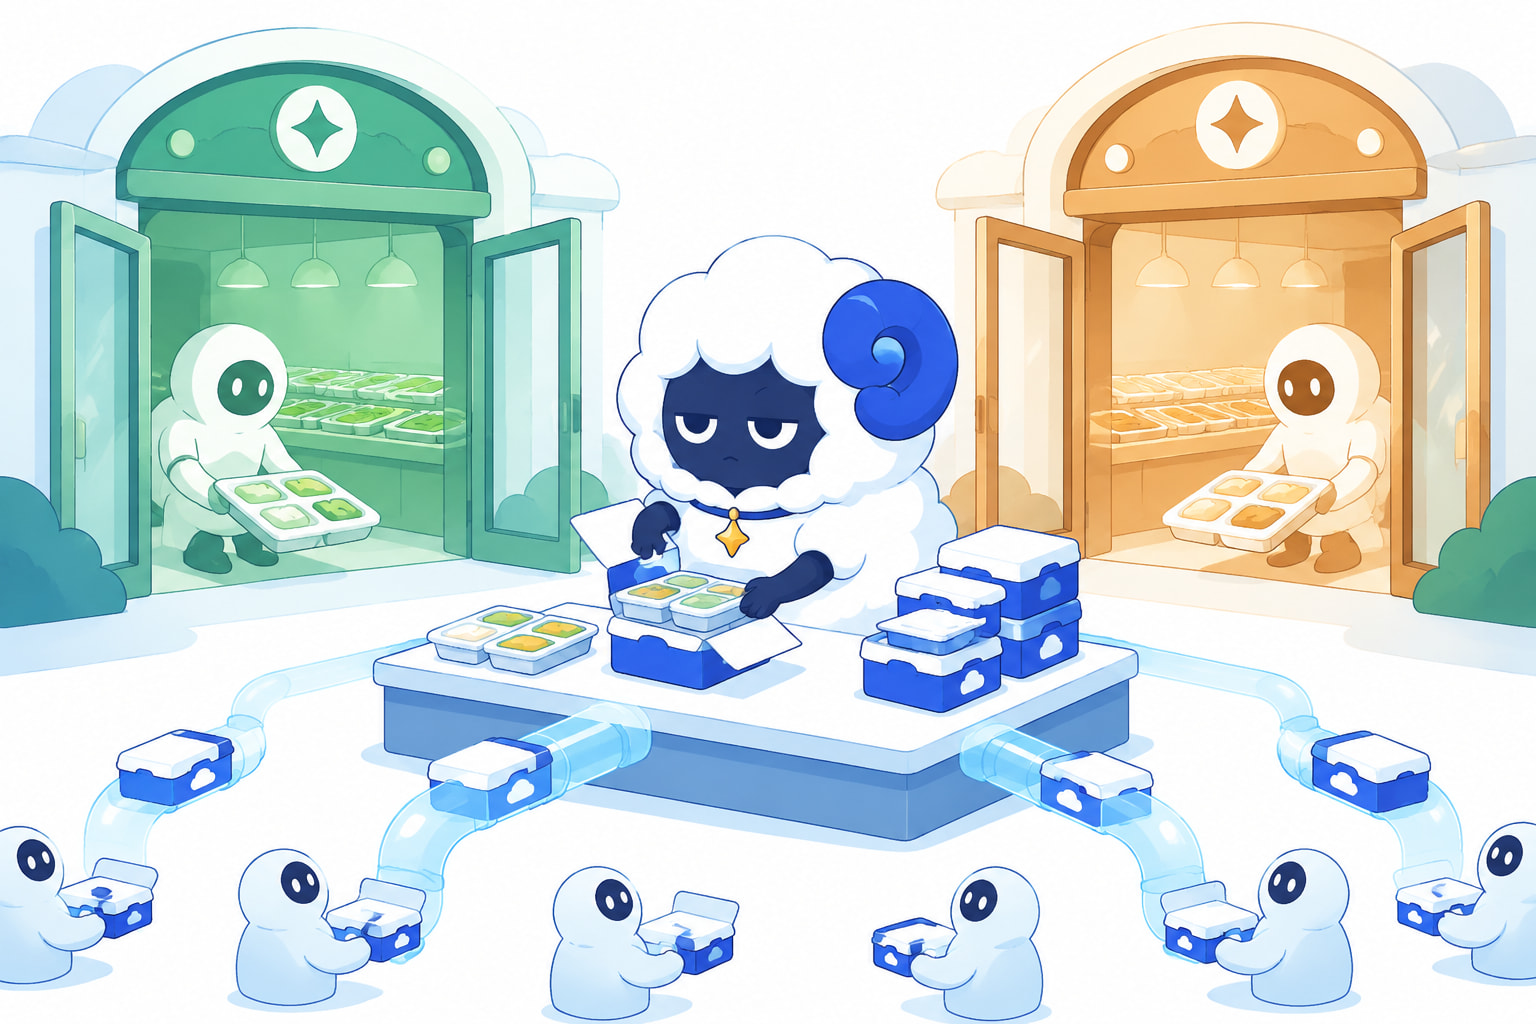
sub2api 是在订阅上进行分发的程序。虽然 newapi 也有类似能力,但这不是 newapi 的重点。它更侧重于怎么把订阅分享出来。
订阅可以理解成 AI 厂家开的自助餐;而订阅分发,就是你在店里下了团购,然后站在店门口,把饭端出去分给外面的人吃。
所以 sub2api 的主要作用,是分发订阅,同时做防封号以及其他相关操作。
CPA 全名 CLI Proxy API(GitHub - router-for-me/CLIProxyAPI)。
它和 sub2api 一样,也是从订阅拿号,但更侧重于从 CLI,也就是终端程序中获得订阅能力再进行分发。
它的分发属性比较低,更像是自用的订阅中转程序,并且没有计费之类的项目,一般用于拼车以及其他操作。
市面上基本上大部分中转都是类似结构。即使有自建程序,也多是在这些项目的基础上拓展延伸,或者改动 UI 和功能。
基本结构一般是:
newapi 分发  --  CPA / sub2api 上游
sub2api 分发中转站的网络和服务器
说完中转站用的程序,现在来说中转站用的网络以及服务器。
目前中转站中,小型站点一般使用 VPS 服务器。可以通过 ping 来大概判断它使用的网络。常见方案主要有:
- CF,也就是 Cloudflare,作为网络 CDN 加速。有技术能力的站点,会套上优选 IP 给亚太地区加速。
- 亚太 CDN,很多小厂会做亚太 CDN 加速,基本上是日本和香港节点,对国内分发速度比较快。
- 备案后的国内 CDN,比如腾讯 EdgeOne,或者阿里类似的动态加速服务。这些 CDN 支持动态加速,但是需要国内备案,风险更高,所以大部分服务商不会提供。
VPS 常见的有 RackNerd。以前美西机房比较稳定,比较适合建站。除此之外,还有很多其他小厂和不同线路的服务器。这些一般都是小玩家使用的,价格通常在一年 500 元左右,基本低于 1000 元。
用量大的站点,一般会开 OVH 的独服,或者其他独立服务器,追求高带宽,G 口甚至 10G 口。这类服务器一般价格在一年 4000 元以上,不然配置通常比较一般。
中转的真实成本
说到中转的服务器和网络,接下来就了解一下中转的真实成本。
Claude 我不熟悉,这里主要讲 GPT。
GPT 的订阅中转,如果转换为大家使用的额度付费,一般流程是这样的。
首先,把官网定价直接复制到中转后台。然后可以设置:
1 美金 = 多少平台币大部分设置的是:
1 美金 = 1 人民币这样方便计算。但是很多站会设置成:
充 7 元 = 1 美元
充 7.3 元 = 1 美元
充 6.8 元 = 1 美元诸如此类。
除非这个站是真实用美元直接购买官方 API,否则订阅站本身并不需要这样计算。这是一个倍率陷阱。
随后,就是用户使用时的倍率分组。倍率分组就是用来计算真实价格的分组。例如输入 5 元,给你倍率 0.1,那么实际就是:
5 * 0.1 = 0.5 元在前面 1 人民币 = 1 美元 的时候,其实已经做了约等于 1/7 的折扣。到了这里,就是进一步的折扣计算。
订阅号的额度计算
这个倍率一般是怎么给的呢?这就要讲到订阅号的获取。
真实订阅价格和真实额度,大家可以参考 Codex 雷达。
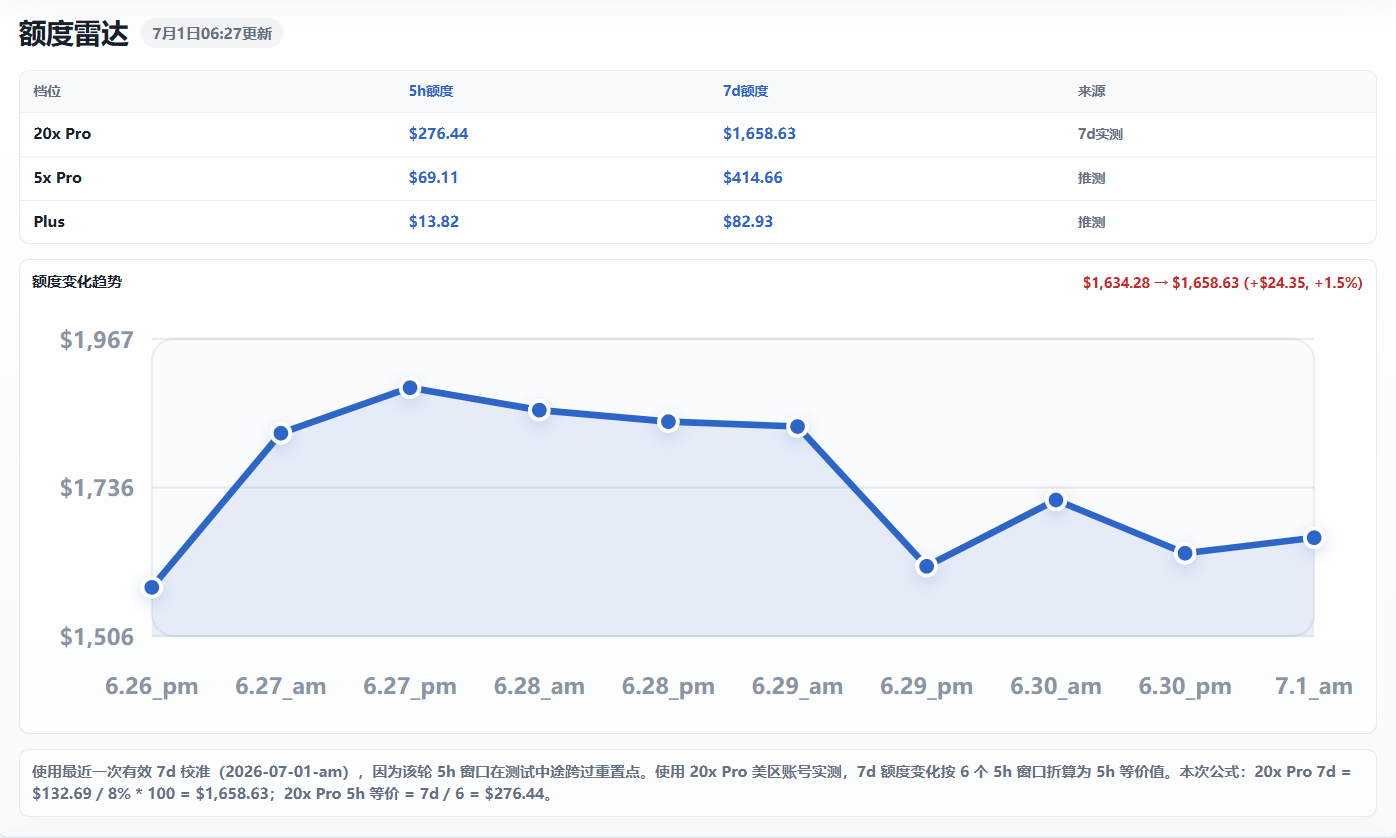
根据图中可以得知,每个 20x Pro 的号,一周满额度一般是 1600+(之前 Pro 的额度约为 2500+,OAI 后来降低了不少额度)。
现在这个额度,乘以 4,就是中转正常获取的额度:
1600 * 4 = 6400在过程中,一般会有 1-2 次重置,也就是额度差不多在:
1600 * 6 = 9600也就是大概 10000 刀。
整体来看,一个号大概能跑出 6000 - 10000 刀,但是只需要 200 美元左右即可撬动。
因为中转站给用户计算时通常按人民币算,也就是成本大概 1400 元,卖出的是 6000-10000 元口径的额度。这时候,如果它的倍率是 0.1,那么:
6000 * 0.1 = 600一个号卖完反而还会亏钱。
1400/6000=0.23 1400/10000=0.14所以现在的中转价格,抛去废号成本,一般 Pro 号倍率会定在 0.2 左右,其他渠道倍率在 0.1 - 0.2 之间。
订阅号是怎么换算成“额度”的
这里很多人容易混淆:200 美元不是买了 1600 美元的官方 API 余额。更准确地说,是这样的:
Pro 订阅本身的真实成本大约是 200 美元 / 月,折合人民币大概 1400 元。
但是 Pro 订阅不是按 API 余额计费,而是按订阅制给你一定的使用量。中转站会把这个使用量拿来跑模型,然后按照 OpenAI 官方 API 的价格反推:如果这些请求不用订阅号,而是直接走官方 API,大概要花多少钱?
假设一个 Pro 号一周能跑出相当于 1600 美元官方 API 价格的用量,那么这个 1600 美元并不是现金,而是“按官方 API 标价折算出来的额度”。
中转站后台通常又会把 1 美元额度 = 1 元人民币额度 这样记账。所以一周的折算关系就变成:
Pro 订阅真实成本:约 1400 元/月
一周可跑出的 API 标价额度:约 1600 美元
中转后台折算后:约 1600 元平台额度一个月按 4 周算:
1600 * 4 = 6400也就是说,一个成本约 1400 元 / 月 的 Pro 订阅号,如果稳定跑满,一个月大约可以榨出 6400 元口径的平台额度。这里的核心差价就在于:
真实成本:1400 元
折算额度:6400 元但这还不是最终利润,因为中转站通常还会给用户设置倍率。比如倍率是 0.2,用户实际消耗就是:
6400 * 0.2 = 1280 元这时候,一个 Pro 号如果只跑出 6400 元口径额度,卖 0.2 倍率反而可能接近亏本。只有当账号出现重置、跑出更多额度,或者账号成本更低时,才有利润空间。
所以看中转价格时,不能只看“官方 API 标价额度”,还要看三件事:
- 订阅真实成本
- 按 API 标价折算出来的额度
- 中转卖给用户时的倍率
这三层分清楚,才能看懂为什么有些站倍率能做到 0.1、0.2,也能看懂为什么太低的价格往往意味着渠道风险更高。
除了 Pro 号,还有什么渠道
那么除了 Pro 号之外,这些渠道都是什么?为什么可以这么便宜,甚至之前能做到 0.01?
这些就是传说中的:Bug Team、首月 Plus、黑冲、逆向、黑灰产。
Bug Team
指的是 OAI 企业订阅里偶发性的 bug。例如之前,只要 0.52 美元就可以开企业账户,然后通过分发获取接近 Plus 的额度。那段时间出现过很多公益站。
这种渠道一般不会长期存在,主要取决于平台什么时候发现并修复。
首月 Plus
指的是 OAI 会给不同地区的用户首月优惠,只需要提供支付方式,就可以开通账号。这个方式包括:
- 虚拟卡台,基本没了
- 欧洲支付,目前健在
- PayPal 支付,基本半死
- GoPay,基本没了
- 巴西 Pix,基本没了
- 其他各种地区支付方式
可以说,只要 OAI 还有优惠,就会有人想办法获取。这个方式一般也有 K12 等未说明的渠道。
黑冲
原本指的是海外盗用信用卡消费、盗用礼品卡消费,甚至有一些是黑产渠道直销。现在大多数指的是 Google 等第三方支付平台。
原理是用户用这些支付平台付费给 OAI,然后向平台反馈说“我被盗了,帮我追回”。平台追回后,OAI 那边还要 1-3 天左右才能同步知道。这时候会员还在,中转站可能已经刷完了一个周限 2500 刀,如果有重置,就可能刷完 5000 刀。
逆向
指的是通过第三方支持流式输出的平台,或者不支持的平台,例如 Kiro、第三方 IDE 或其他产品,获取它们与 OAI 不同的接口,自己写注册和转发逻辑,然后把这些产品拿过来给用户使用。
这种接口做对话 OK,coding 不 OK。现在一般是 image2 的 1K 使用这个方式,或者一些公益站会使用。
黑灰产
其实上面这些很多都已经属于灰色渠道。但这里说的黑灰产,是更恶劣、更没有底线的方式。如果说上面的方式还可以说是利用规则漏洞,那么这种就是直接损害他人利益。
第一种,盗用 key。在 GitHub、各大社群,通过各种方式,比如搜索 key、诱导新手发送 key、发送免费公益站截留数据,甚至渗透盗用其他 key。
第二种,盗用余额。oneapi、newapi、sub2api 等程序,很多是非商业用户自己部署的。他们对公网部署不熟悉,使用通用密码,或者开放了注册和赠金、邀请赠金,就会被利用。
第三种,论坛脚本。在论坛以及其他社区部署监控脚本。只要出现公益站、免费 key、用不完的分享 key,这些 key 一经发布,就会被监控到,并且被利用。
便宜渠道的风险
中转站的便宜渠道一般就来自于上面这些,一般可以做到 0.04 - 0.1 区间。这些渠道往往会有以下风险。
1. 缓存额外价格
因为你可能现在发了一堆消息给 A 号,然后在下一次对话的时候是 B 号承接。如果 A 号被封了,就会导致缓存无法继续命中,实际成本提高。
2. 被二次利用
因为他们接入的上游并不是中转自己,可能是别人的号。别人发现被盗用后,可能会开启截留数据。甚至这个上游本来就是为了数据做的蜜罐,而你就是被坑骗的用户。
3. 降智
逆向会附带 IDE,也就是程序本身自带的上下文。这会导致上下文被重复覆盖,最终表现变差。
4. 被替换模型、掺水
因为低价,所以很多人不会认真核验。掺 Mimo 都算好的。不过豆包模型很多时候比 OAI 这类渠道还贵,所以一般不会有人掺豆包,会亏钱。
以上为转载内容。
目前不做任何中转站的推荐,如果良心站长有合作意向欢迎洽谈。
编辑器里的 AI:VS Code 与 Cursor
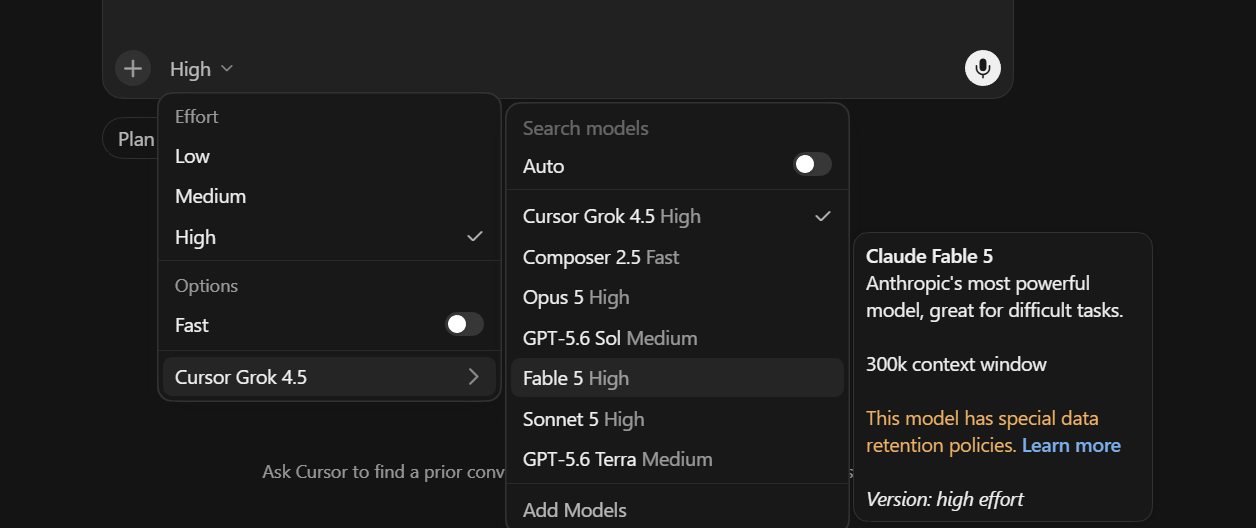
第 3 节我们以命令行为主线,而 AI 也可以直接长在编辑器里。这有两条路:VS Code 装插件,或者用 Cursor——它其实是 VS Code 的一个分支,插件、快捷键、配置基本都能沿用,所以从 VS Code 迁过去几乎没有学习成本。
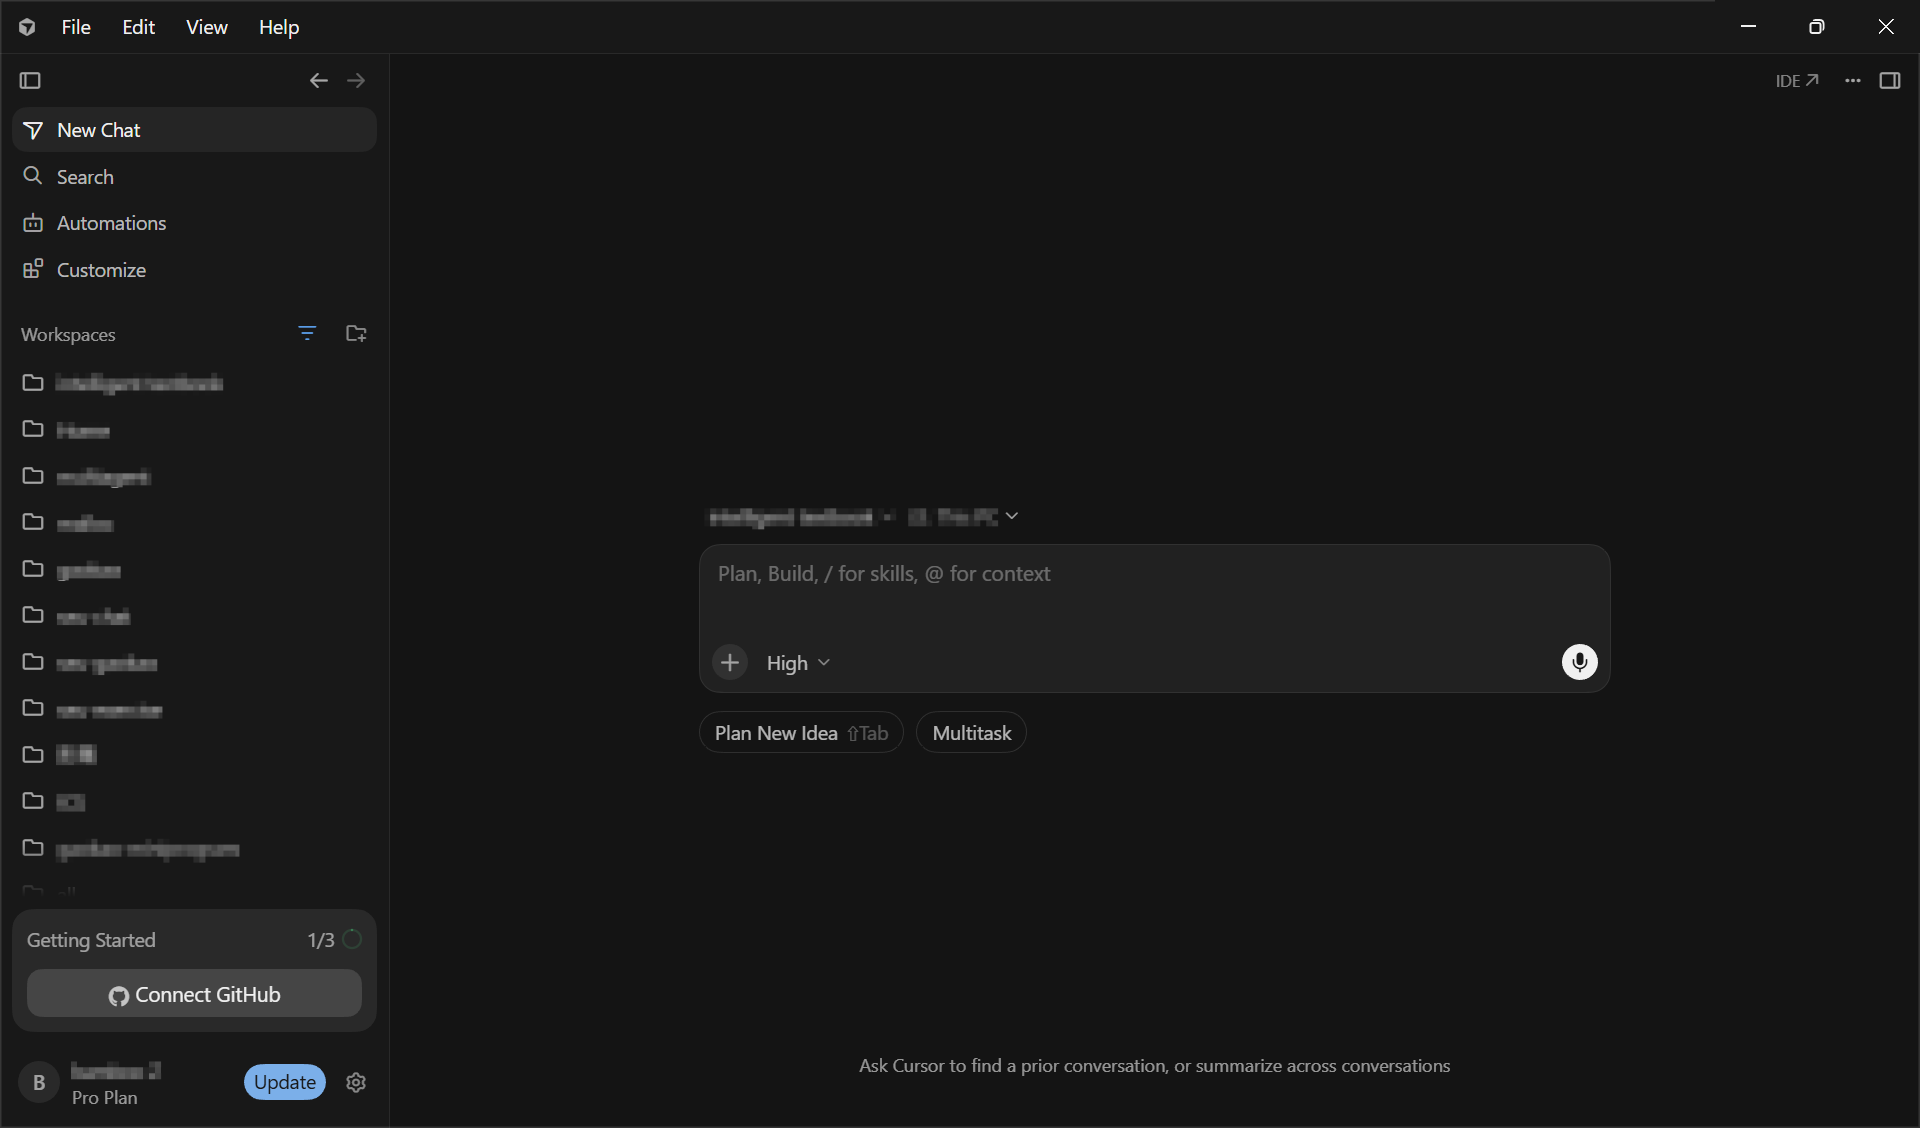
Cursor 有一个 Agents Window 模式,可以直接打开对话框,非常方便。
上下文:AI 唯一的工作记忆
回到我们一开始的问题:vibe coding 究竟有哪些地方不太擅长?如何改进?
我认为不存在一个固定的工作流程(workflow)能让 AI 在任何情况下都效率最大化,但是我觉得只要理解一些较浅的原理,就可以让你在使用 harness 的时候知道哪些东西需要注意,进而拉开和“许愿式编程”的差距。
上下文就是一个在 LLM 领域很重要的概念。
AI 不记得你。它每一次回答,靠的只是这一次递到它眼前的那些文字:你的提问、这段对话之前的内容、它读过的文件、跑出来的报错。这些东西合起来叫上下文,它就是 AI 全部的工作记忆。
知道这一点,新手最常见的两个困惑就有答案了。
第一,它不会替你补你没说的话。 第 4 节那句"AI 执行的是你写下的那句话,不是你脑子里的那件事",原因就在这里。所以提需求的时候多说一句:想要什么结果(最好是跑一下就知道对不对的那种)、有什么不能碰(不能改接口、不能装新库、这个文件别动)、去看哪个文件。反过来,凡是它自己能读到的东西就别转述——报错直接贴原文,比你复述"它说找不到什么什么"准得多。
第二,聊得越久它越笨。 上下文有容量上限,满了之后早期的对话会被丢掉,于是你开头交代过的要求,聊到后面它就忘了。而且远没到上限它就开始变差:一段绕了半小时的对话里堆着三个废弃方案、五条早就修好的报错,这些东西还在它眼前,一直在和你真正的需求抢注意力。
所以有一条最省事的习惯:跑偏了就直接开新会话。 不要试着在一条已经聊废的对话里把它掰回来,你掰不回来。把现在的状态重新说两句,从干净的上下文开始,往往一次就过了。相应地,每次只让它改一件能立刻验证的事,而不是攒够十个改动一起崩。
在这里可以介绍几个相对实用的工具。前两个是 Claude Code 的斜杠命令,在对话框里直接输入:
/clear清空当前会话的全部上下文,恢复到刚刚打开 Claude Code 的状态,它的记忆将会变成一张白纸。清掉的那条对话并没有被删除,可以用 /resume 找回来。
/compact压缩上下文:把之前的对话总结成一小段,然后拿这段总结替换掉原文。代价是会丢失一些信息,而且越到后面压缩的效率越低。Claude Code 在快满的时候会自己压一次,所以你很少需要手动敲它。
手动敲的价值在于你可以指定保留什么:
/compact 只保留和登录逻辑相关的部分,前面调 CSS 的过程不用留自动压缩并不知道你接下来要干什么,只能按"看起来重要"去猜,经常把你马上要用的细节丢掉。你自己交代一句,该留的就能留下来。两个值得手动压一次的时机:话题刚换,以及你已经知道接下来只围绕某一个文件展开。
第三个不是命令,而是一句你可以直接写进需求里的话:
为了节约上下文,请使用 Subagent 完成这项任务加上这一行之后,AI 会自动开启几个分身,好比是请了几个枪手,每个枪手做完题目之后仅仅把答案告诉本体,而那些思考过程可能跟后面的事情没有关系,所以本体不需要知道这些占用上下文的信息。
还有一点,做一个大规模的项目的时候,应该让 AI 先把详细计划列成一个文档,你跟它沟通确认没有问题之后再动手。因为生成具体代码会有大量输出,占用大量上下文,如果没有做好计划,很容易写到后面就忘了前面;而计划文档本身写不了多长,更关键的是它落在硬盘上——就算中途 /clear 或者被自动压缩掉,让它重新读一遍文档就能接着干。
"先出计划再动手"这件事,Claude Code 干脆做成了一个内置模式,叫 plan mode。连按 Shift+Tab 会在几种权限模式之间循环,其中一档就是它,切进去之后左下角会显示 plan mode on——正好是前面那个 bypass permissions on 的反面。
在这个模式下,它可以读文件、翻代码、查资料,但不会写任何文件,也不会执行会改动东西的命令。它只会把"我打算怎么做"讲给你听,等你点头之后才退出这个模式开始动手。
别翻车:安全、诚信与边界
这一章前面都在讲怎么借助 AI 开得更快,最后讲几件能让你别翻车的事。
API Key 不要进 Git。 这是新手最常见、后果也最直接的一次翻车:key 写在代码里,代码推上 GitHub,几分钟之内就会被专门扫仓库的脚本捡走,然后有人拿你的余额去跑他自己的活。所以 key 只放两个地方:本章配置过的那种 settings.json(它在家目录里,不在项目里),或者项目里的 .env 文件加上 .gitignore(参见 Git 与 GitHub:.gitignore 与安全提醒)。已经推上去了怎么办?第一件事是去平台把那个 key 删掉重建,改 commit 历史是次要的——已经泄露出去的 key,不会因为你改了历史就重新变安全。
不要什么都往来源不明的服务里喂。 第 4 节讲中转站时那句话在这里再说一遍:你发出去的每一个字,都完整地经过了对方的服务器。两类东西要格外小心——你的身份信息(学号、证件、简历原文),以及不属于你的代码(实验室的、实习公司的、别人授权给你看的)。前者泄露是你自己吃亏,后者可能已经是违约了。判断标准很简单:这段东西如果明天出现在一个陌生论坛上,你会不会有麻烦?会,就别发。
一个没人看着的 agent 是真的会烧钱的。 按量付费的时候,它每读一次文件、每重试一次,都在花钱。真正出事的组合是:权限确认关掉了 + 让它自己循环去做一件它其实做不到的事——它会一遍一遍地试,而你已经去吃饭了。所以按量付费的账号一定要去平台设一个消费上限或者用量提醒,别指望自己记得去看余额。这也是本章一开始只让你充十块钱的原因之一。
最后是学术诚信,这条最容易被忽略。 用 AI 写课程作业,不同老师、不同课程的规定差别很大:有的完全允许,有的要求你在报告里注明用了什么工具、用在哪一部分,也有的明确禁止。留意一下第一节介绍课的 PPT,或者问一问老师,成本远低于事后解释。另外要分清两件不一样的事:交一份 AI 帮你写的作业,和交一份你自己完全看不懂的作业。后者哪怕规定允许,这门课你也已经白上了。
最后我想说:会用 AI,不等于完全不用学基础。
随着模型越来越强,我们不再需要从 0 开始学很多东西,而是需要去用非传统的路径去学习,其实这给我们的学习过程带来了新的挑战。笔者认为,与其学习如何成为一个程序员,更应该去按照成为一个领导者的方法去点技能点。作为 AI-native 的一代,我们很不幸地没有机会像老登那样可以花大量时间精通某一门语言或者是某一项技术,但是我们有更好的创造力,能够开发出 AI 更多的用途——skills/tools/mcp,我觉得这是性价比更高的学习路径。


正在加载评论...